この記事はリライトしました
初回公開日:2025-07-18
リライト更新日:2026-09-30
旧タイトル:【2025年最新】AIが解く800年の謎!古文書解読の驚異的進展と歴史発見の新時代
主な変更点
- 研究対象ごとに再構成、2026年の一次資料更新
- 家庭の手紙は仮想例と明示、転写と推測を分離
- 見える痕跡と生成した候補を混同しない
AIは、見えない文字を取り出したり、欠けた文章の候補を示したり、似た史料を探したりする研究を助けています。ただし、これらの成果から「未知の言語を何でも解読できる」とは言えません。
2026年には、炭化して開けないヘルクラネウムの巻物について、残存部分を仮想的に展開し、連続した文章として読んだという報告が出ました。2022年のIthaca、2025年のAeneasでは、古代の碑文を復元したり、文脈を調べたりする支援が進んでいます。成果はそれぞれ、対象、入力資料、評価方法が異なります。
「AIが歴史の謎を解いた」と聞くと、映画のような瞬間を想像します。しかし、実際に面白いのは、画像の中の小さな痕跡、文字の候補、別の場所で見つかった似た表現を、研究者がつないでいく過程です。
この記事では、確認できる研究を入口に、AIが過去の声に近づく方法と、その声を勝手に作らないための確認を考えます。
原公開日:2025年7月18日。事実確認日:2026年9月30日。旧稿の「800年の謎」「95%の精度」という一括した表現は、対象と根拠を確認できないため使用していません。
古文書を「読む」と「解読する」は、どう違いますか?

同じ「読めた」という言葉でも、実際の課題はいくつかあります。
| 課題 | 分からないもの | AIなどが支援すること | それだけでは分からないもの |
|---|---|---|---|
画像から文字を取り出す | 折り重なった紙面、薄いインク、見えない内部 | 表面の検出、画像の展開、インクの痕跡の抽出 | 文章の意味や歴史的な解釈 |
文字を転写する | 字形や筆跡の読み方 | 文字列の候補を出す | 読みが正しいか、略字の意味 |
欠損を復元する | 失われた文字や語句 | 文脈に合う候補を挙げる | その候補が実際に書かれていたか |
文脈を調べる | 年代、地域、類似した記述 | 関係しそうな史料を探す | 類似した理由、歴史上の出来事の全体像 |
未知の文字体系・言語を解読する | 記号が何を表し、どんな規則で使われたか | 規則性や仮説の検討を助ける可能性 | 記号と音・意味の対応が確立したか |
例えば、既知のギリシャ語の碑文で一部が欠けている場合と、そもそも文字体系の読み方が分からない場合では、利用できる手掛かりが違います。前者では、残った文や他の碑文が候補の条件になります。後者では、もっと根本から対応関係を確かめる必要があります。
ここで区別したいのは、「もっともらしい文章」と「史料に支えられた読み」です。文として自然でも、石や紙に残っている文字と合わなければ、その復元は採用できません。
AIが出した候補が魅力的な物語であればあるほど、いったん画像や原資料に戻る必要があります。歴史研究で面白い結論を出すことと、その結論を裏づけることは、同じ作業ではありません。
炭化した巻物は、開かずにどうやって読むのですか?

2026年の報告が示したこと
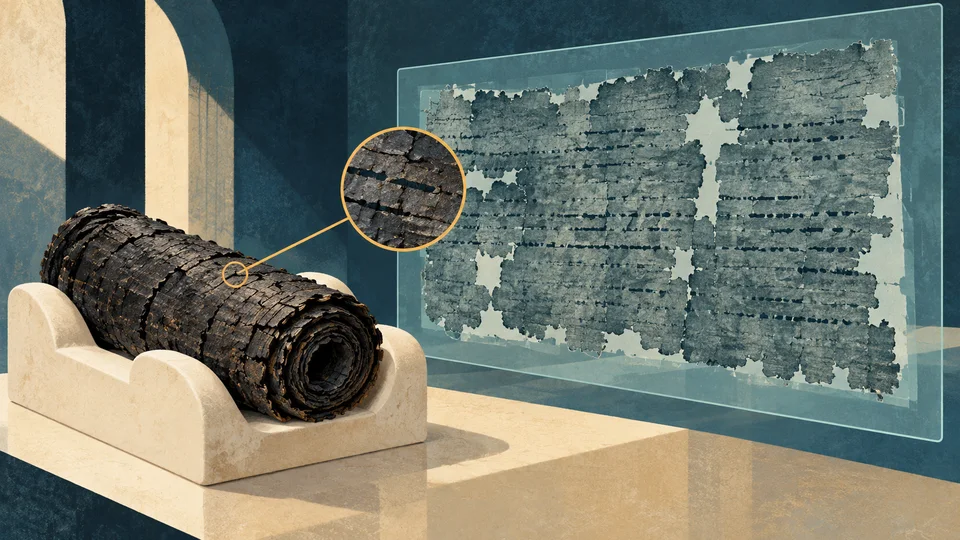
ヘルクラネウムの炭化したパピルスは、物理的に開くと壊れるおそれがあります。Vesuvius Challengeの研究者らは2026年6月25日、PHerc. 1667について、残っている巻物の部分を仮想的に展開し、連続して読める状態にしたと発表しました。対象には、かつて失われた外側の部分や、元の一冊全体まで含まれるわけではありません。Vesuvius Challengeによる成果の説明
研究の流れは、おおむね次のように整理できます。
- X線を使って、巻物の内部を立体的なデータとして取得する。
- 重なった紙面の表面を計算によってたどる。
- 曲がった表面を、読むための平面に対応づける。
- 機械学習などを使って、インクの痕跡を取り出す。
- パピルスを研究する専門家が、文字と文脈を検討する。
これは「ありそうな古代文をAIに書かせた」という成果ではありません。資料の内部にある物理的な情報を読み取り、文字の痕跡と対応させている点が重要です。2026年6月27日投稿の論文は、この方法や読み取りの条件を報告したプレプリントです。この記事では、査読済みの最終的な評価が確定したとは扱いません。研究論文の要旨・公開状況
「全体を読めた」は、何の全体ですか?
ニュースを読むときに確認したいのは、「全文」「完全」「全体」が何を指すかです。
現在残っている巻物の部分を端から端まで扱えたという意味と、古代に書かれた一冊の全部を取り戻したという意味は違います。傷んだ面の欠落がなくなったという意味でもありません。
この区別は、成果を小さく見せるためのものではありません。どこまで進めたかを正確に理解すると、次の課題も分かります。表面を追える範囲を増やすこと、よりはっきりしたインクの信号を得ること、読みの検証を積み重ねることは、それぞれ別の前進です。
私がこの研究に面白さを感じるのは、失われたものを想像で埋める前に、残っているものを丁寧に取り出している点です。AIの創作力とは異なる方向で、計算が歴史に触れています。
IthacaやAeneasは、碑文の何を助けるのですか?

Ithaca:欠けた文字の候補を示す
Ithacaは、古代ギリシャ語の碑文の欠損を復元し、年代や地理的な位置づけを助ける研究として2022年に発表されました。入力は碑文を文字に起こした資料です。「読めない写真を入れると未知の言語が日本語になる」という仕組みではありません。Google DeepMindによるIthacaの研究説明
Ithacaが候補を出したとき、研究者は次のような材料と照らして考えます。
- 残っている文字や、空いている部分の長さと合うか。
- その地域や時期で使われる表現として考えられるか。
- 同じ文が、別の意味でも成立しないか。
- 候補を採用すると、他の史料と矛盾しないか。
「候補が一つ出た」と「答えが一つに決まった」は違います。確率が高い候補でも、それを否定する資料があれば見直す必要があります。逆に、候補が複数あること自体が、議論の焦点を明らかにする場合もあります。
精度の数字は、研究の条件と一緒に読む
Ithacaの研究紹介では、欠損復元についてモデル単独62%、歴史研究者が支援を受けた場合72%という結果が説明されています。これらは、研究で設定された課題と評価方法における結果です。世界中の古文書の62%や72%を読めるという意味でも、未知の文字を同じ割合で解読できるという意味でもありません。Ithacaの評価説明
ある用途で有望な結果が出たら、別の用途でもすぐ同じ精度になるでしょうか。筆記の種類、言語、時代、資料の偏りが変わると、手掛かりも変わります。数値だけを大きく見せるより、入力と比較対象を確かめる方が、研究の価値を理解できます。
Aeneas:似た碑文を探し、文脈を考える
2025年発表のAeneasは、ラテン語の碑文について、関連する碑文を探し、復元や年代・地域の検討を助ける研究です。文字列や画像を使い、大きな碑文の資料群の中で、文脈的なつながりを探します。Google DeepMindによるAeneasの説明
例えば、ある奉納文に珍しい表現があるとします。似た表現が別の場所でも見つかれば、研究者は両者を比較できます。ただし、似た表現があるだけでは、同じ人が書いた、同じ時期だった、同じ意味だったとは決まりません。
ここでのAIの役割は、広い資料群から比較の入口を増やすことです。その入口が重要な発見につながるかどうかは、史料の内容と研究者の検討にかかっています。
2026年7月には、Durham大学が、IthacaやAeneasを基にした対話型の研究支援環境も紹介しています。対話で質問できる形が増えても、回答の根拠となる碑文や読みの確認は必要です。Durham大学の2026年7月8日の発表
ヴォイニッチ手稿の謎も、解けたのでしょうか?
今回確認したYale大学図書館の資料では、ヴォイニッチ手稿は15世紀の写本として紹介され、その意味を巡る探究が続いていると説明されています。旧稿の「800年の謎」という年代表現は、その資料と整合しません。Yale大学図書館の2024年の記事
この記事の調査では、AIによってヴォイニッチ手稿の完全な解読が確立したと裏づける一次資料は確認できませんでした。一つの仮説や、ある部分が読めるという主張を、全体の解読と同じには扱えません。
これは、「今後も絶対に解けない」という意味ではありません。未知の記号には規則があるかもしれませんし、過去の仮説を見直す材料も増えるかもしれません。しかし、「パターンが見つかった」「既知の言語に似ている」「翻訳らしい文が生成された」という段階では、記号の読みと意味が確立したとは言えません。
仮説を評価するときは、少なくとも次の問いが役立ちます。
- 同じ記号に、同じ規則を一貫して適用しているか。
- 都合のよい箇所だけでなく、他の箇所にも説明が通るか。
- 推測を始める前からある史料や外部の手掛かりと合うか。
- 別の研究者が方法をたどり、同じ結果を検討できるか。
- 合わない例や、残っている問題が公開されているか。
これらは、このブログで仮説を読むために整理した確認の視点です。特定の手稿の解読を採点する公式基準ではありません。
「ついに読めた」という見出しは、とても魅力的です。それでも、何を、どの方法で、どこまで読めたかを確認してから驚きたいと思います。その方が、本当に新しい発見を見落とさずに済みます。
身近な古い手紙をAIに見せるなら、どう進めますか?

ここからは、家に残った古い手紙を読むという説明用の仮想例です。専門研究の性能を、一般的な画像対応チャットAIで再現できるという実験結果ではありません。
手順1:資料を傷めず、読める範囲を記録する
壊れそうな紙を無理に開いたり、撮影のために傷めたりすることは避けます。扱いが難しい資料は、所蔵機関や保存・史料の専門家に相談する方がよい場合があります。
画像を用意できたら、元の画像を残し、撮影した面や順序を記録します。文字が見えるように加工した画像と、元の画像を区別しておくと、加工が読みの根拠になったのかを見直せます。
手順2:読めた文字と推測を別にする
AIに「この手紙を感動的に解読して」と頼むと、意味が通る文を優先して補う可能性があります。まず、見える文字を起こす作業、読みの候補を出す作業、現代語にする作業を分けます。
例えば、一行の中央が読めないなら、最初は空欄を残します。「農作業」「家計」「旅の予定」といった話題も、画像から確かめられる材料が揃うまでは仮説です。
手順3:個人情報や公開してよい範囲を確認する
古い資料にも、住所や家族関係、健康状態など、本人や関係者にとって慎重に扱いたい情報が含まれることがあります。外部のAIサービスへ送る前に、利用条件、情報の扱い、関係者への配慮を確認します。
「昔のものだから何でも公開してよい」とは限りません。読めた内容をブログに載せることと、自分で確認することも別の判断です。
手順4:確かめた範囲を、読みの記録として残す
| 記録するもの | 説明用の記入例 |
|---|---|
画像の位置 | 2枚目、上から3行目 |
確認できる文字 | 読めた部分をそのまま記録 |
読めない部分 | 空欄や「判読できず」と明示 |
候補 | 候補A、候補Bを別々に書く |
根拠 | 字形、前後の文、別のページの表記など |
未確認事項 | 日付、固有名詞、略字の意味など |
AIとの会話が長くなっても、根拠が増えたとは限りません。候補を何回生成したかより、画像や他の資料で何を確かめたかを残します。
読みと推測を分けるための依頼テンプレート
次の依頼は、生成AIの回答を整理するための例です。文字認識の精度や正しい読みを保証するものではありません。
この画像について、見える文字の転写、推測した候補、意味の説明を分けてください。 判読できない部分は埋めず、画像内の位置を示してください。 読みの候補が複数ある場合は、それぞれの根拠と、追加で確認したい材料を挙げてください。 実在の人物や出来事を、根拠なく特定しないでください。
回答を受け取ったら、見える文字の欄から原画像と照合します。現代語訳は、転写と候補が検討できてから扱います。
AIが過去の声を増やすと、歴史の見方はどう変わりますか?
これからの可能性として私が考えるのは、有名な人物の記録だけでなく、読まれにくかった資料に触れる入口が増えることです。壊れやすい資料、膨大な碑文、見慣れない文字が、研究や学習の対象として扱いやすくなるかもしれません。
ただし、AIが資料を探せるようになっても、もともと残っている資料の偏りは消えません。記録を残せた人、保存された地域、後世に選ばれた文章に偏りがあれば、それを考える必要があります。「大量に読めたから全員の声が分かった」とは言えません。
また、読めた文には、その文を書いた人の立場があります。碑文にある功績が、出来事の公平な記録とは限りません。読みが正確になった後でも、誰が、誰に向けて、何のために書いたかという問いが残ります。
これは将来を確定的に予測する記述ではなく、研究成果から私が考えた可能性と課題です。AIが歴史家の仕事をなくすというより、確かめる材料と問いの数が増える場面がありそうだと感じます。
過去の人の言葉に近づけるのは、わくわくします。同時に、その人が言っていないことまで、滑らかな文章で代弁してしまう怖さもあります。読み取った痕跡、復元の候補、歴史の解釈を分けることが、その境目を守る方法になるのだと思います。
よくある質問
AIを使えば、古文書研究の専門知識は要らなくなりますか?
確認した研究では、文字や年代の候補を史料と照らし、解釈する専門家の仕事が重要です。AIの出力だけで、文字の読みや歴史的な意味が確定するわけではありません。
古文書の写真をChatGPTなどに入れれば、正しく訳せますか?
一般的なチャットAIの結果は、資料や画像の状態、言語、サービスなどによって変わります。専門研究で得られた精度を、そのまま当てはめることはできません。見える文字、推測、訳を分け、元の画像と照合します。
「完全に読めた」という報告は信用してよいですか?
報告の対象範囲、方法、残っている欠損、公開された根拠、査読などの状況を確認します。「残存部分全体」と「元の一冊全体」が違う場合もあります。
ヴォイニッチ手稿をAIが解読したという話は本当ですか?
この記事の調査では、完全解読が確立したと裏づける一次資料は確認できませんでした。Yale大学図書館の紹介は15世紀の写本についての探究を扱っています。新しい主張は、方法と検証の範囲を確認して判断する必要があります。
更新情報と主な確認資料
2026年9月30日、旧稿の包括的な精度、確認できない研究機関・人物の発言、年代の誤り、架空の発見事例を削除しました。2026年の巻物研究はプレプリントの公開状況を明示し、Ithaca・Aeneas・未知言語の解読を区別して再構成しています。
- Vesuvius Challenge:First complete scroll
- 2026年の巻物研究プレプリント
- Google DeepMind:Ithaca
- Google DeepMind:Aeneas
- Durham大学:2026年の研究支援環境
- Yale大学図書館:ヴォイニッチ手稿
記事の制作と確認について
AIを下書きや構成の整理に活用し、主張を一次資料と照合してリライトしました。参照した資料と確認範囲は、本文の出典・注意点に記載しています。
製品の仕様や制度は変更されることがあります。利用する際は、本文で示した条件と最新の公式情報を確認してください。